LLM-wiki: второй мозг для вашего ИИ
Предлагаю практическое руководство по созданию «второго мозга» для вашей LLM: что такое LLM-wiki, зачем он нужен в любом проекте, как его вести, наполнять и автоматизировать, и почему он может оказаться эффективнее традиционного RAG.
Вступление
Паттерн «Второй мозг» давно знаком людям, работающим с информацией. Мы привыкли выгружать идеи, заметки и знания во внешние системы: Obsidian, Notion, Logseq, чтобы не держать всё в голове и иметь возможность вернуться к нужному фрагменту через месяцы. Obsidian стал де-факто стандартом для локальной базы знаний: markdown-файлы, граф связей, плагины, полный контроль над данными.
Но вот в чём проблема: у вашей LLM такого «второго мозга« нет. Каждая новая сессия начинается с чистого листа. Модель не помнит, что вы обсуждали вчера, какие решения приняли, какие грабли собрали. Вы снова и снова пересказываете ей контекст проекта, тратите токены на повторное объяснение, а качество ответов страдает от нехватки истории.
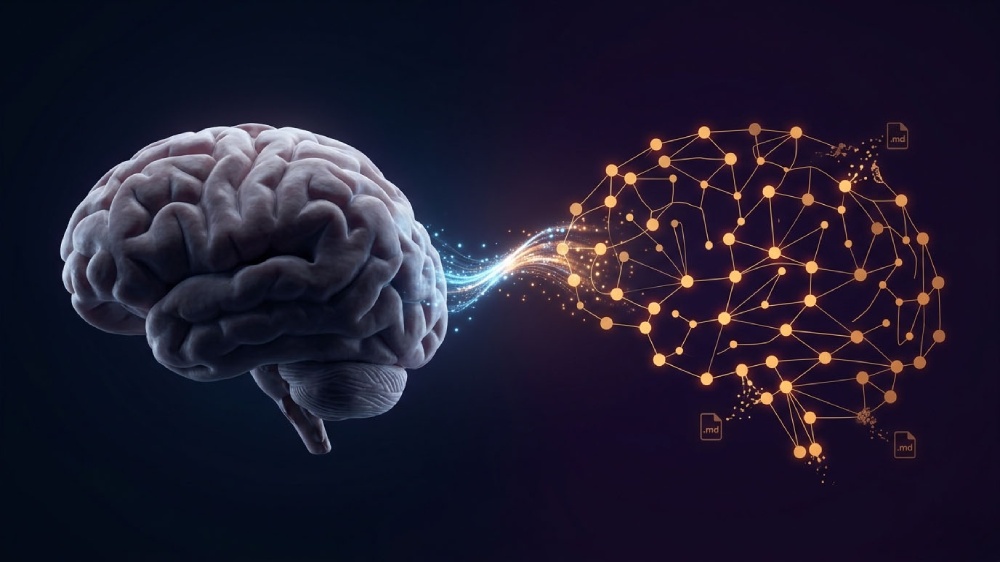
В апреле 2026 года Андрей Карпати предложил паттерн LLM-wiki — подход, при котором LLM не просто отвечает на вопросы, а компилирует ваши сырые источники в структурированную, кросс-ссылочную markdown-вики, которую потом сама же и использует. Это не замена Obsidian для человека — это второй мозг для вашего ИИ, который живёт в том же Vault’е и наполняется автоматически.
В этой статье мы разберём: как LLM-wiki работает, чем он отличается от RAG, какие у него плюсы и минусы, как его вести и обновлять, как подружить со скилами, MCP и тасками, и посмотрим сколько токенов это экономит на самом деле.
Что такое LLM-wiki и зачем он нужен
LLM-wiki – это паттерн, в котором LLM выступает в роли компилятора знаний, а не просто генератора ответов. Вы кладёте сырые источники (PDF, статьи, транскрипты, заметки) в папку raw/. LLM читает их, извлекает сущности и концепции, пишет страницы-саммари, обновляет страницы связанных сущностей, помечает противоречия и поддерживает кросс-ссылки. Результат — папка wiki/ с markdown-файлами, которые вы можете просматривать в Obsidian.
Ключевая идея: знание компилируется один раз при поступлении источника, а не переоткрывается при каждом запросе. Как пишет Карпати: «Чтобы агенты не переоткрывали всё заново каждый раз, нужен скомпилированный артефакт знания».
Почему это стало актуально именно сейчас
- Контекстные окна выросли — 128K–1KK токенов у современных моделей позволяют держать в контексте целую вики проекта.
- Агентные фреймворки требуют памяти — Claude Code, Cursor, Codex и другие агенты работают в сессиях, но без внешней памяти каждая сессия начинается с нуля.
- RAG не всегда оправдан — для небольших (<100K токенов), стабильных баз знаний векторный поиск добавляет сложность, но не даёт пропорциональной выгоды.
Cравнение LLM-wiki и RAG
Главный вопрос, который возникает при знакомстве с LLM-wiki: «А чем это лучше RAG?» Ответ – это разные инструменты для разных задач. Вот честное сравнение:
| Критерий | RAG (векторный поиск) | LLM-wiki (скомпилированная вики) |
|---|---|---|
| Когда строится знание | В момент запроса (query-time) | В момент поступления источника (ingest-time) |
| Кросс-ссылки | Ad hoc, часто пропускаются | Предварительно построенный граф связей |
| Точность (recall) | Вероятностная — может пропустить чанк | Точная — модель читает уже синтезированную страницу |
| Масштаб | Тысячи документов, enterprise-уровень | До ~100K токенов (≈2–3 книги) |
| Стоимость токенов | Низкая при больших корпусах (только релевантные чанки) | Выше при частых запросах, но до 54% ниже vs. повторное чтение сырых источников |
| Сложность инфраструктуры | Векторная БД, эмбеддинги, чанкинг | Markdown-файлы, git, Obsidian |
| Атрибуция | Ссылки на чанки, но не всегда точные | Каждая страница ссылается на raw/-источник |
| Обновление знаний | Переиндексация при изменении | Перекомпиляция затронутых страниц + lint битых ссылок |
LLM-wiki выигрывает там, где нужна высокая точность, связность концепций и небольшой стабильный корпус. RAG остаётся незаменимым при масштабе в тысячи документов, динамичных данных и жёстких требованиях к атрибуции.
Нюанс: если вы добавите в LLM-wiki функцию поиска по запросу (модель вызывает lookup-функцию вместо загрузки всего контекста), вы фактически пересечётесь с территорией RAG — просто с вики в роли backing store, а не векторной БД.
Плюсы и минусы LLM-wiki
Плюсы
- Устранение «амнезии сессий» — агент читает уже собранные знания, а не пересказываете вы ему контекст заново.
- Кросс-агентная совместимость — файлы в plain Markdown, не привязаны к одной модели или инструменту. Claude Code, Codex, Cursor — все читают одну вики.
- Полная прослеживаемость — каждая страница цитирует исходный источник в
raw/. Вы всегда можете проверить, откуда взялось утверждение. - Хранение прямо в проекте с контролем версий — Vault с вики можно положить внутрь репозитория проекта (или подключить как git-submodule) и вести в обычном
git. Это даёт полноценный контроль версий: вы видите, кто, когда и в рамках какой задачи наполнил базу, какие артефакты появились вместе с новым коммитом, а какие были отредактированы или удалены. Вики эволюционирует синхронно с кодом, а не живёт где-то «на стороне». - Экономия токенов — бенчмарк 72 прогонов показал 54% меньше токенов и 39% меньше времени по сравнению с прямым чтением/grep при равном качестве.
- Локальность и контроль — всё лежит у вас на диске. Нет внешней векторной БД, нет утечки данных. Семантический поиск может быть локальным.
- Накопительный эффект — знания не «испаряются» после ответа, а приумножаются. Чем больше пользуетесь, тем богаче вики.
Минусы
- Не масштабируется бесконечно — контекстное окно ограничено. Для корпусов >100K токенов нужен гибридный подход (вики + поиск).
- Требует дисциплины — «Качество вики деградирует по мере падения ваших усилий». Нужен lint, ревью, чистка.
- Стоимость ingest — компиляция каждого источника стоит токенов. Для больших корпусов это может быть ощутимо.
- Зависимость от агентного фреймворка — многие реализации завязаны на Claude Code или конкретные MCP-серверы. Портирование на другие платформы не тривиально.
- Риск «мусора на входе — мусора на выходе» — если сырые источники плохие или противоречивые, вики это унаследует.
Как вести, наполнять и обновлять LLM-wiki
Структура хранилища
Базовая структура — трёхслойная:
wiki-vault/
├── raw/          # Неизменяемые исходники (PDF, MD, HTML)
│   └── 2026-04-15-karpathy-llm-wiki.md
├── wiki/         # Скомпилированные страницы (LLM пишет, вы читаете)
│   ├── entities/ # Сущности: люди, компании, технологии
│   ├── concepts/ # Концепции: методы, паттерны
│   ├── sources/  # Страницы-саммари по каждому источнику
│   ├── index.md  # Оглавление вики
│   └── log.md    # Журнал ingest-операций
└── schema/       # Конфигурация: промпты, правила, агентские инструкции
    └── config.yaml
Ключевое правило: raw/ — только для чтения LLM. Модель никогда не пишет туда. Она пишет только в wiki/. Это даёт вам гарантию, что исходники не будут случайно изменены.
Как наполнять
- Кладёте источник в
raw/— PDF, markdown, HTML, транскрипт встречи, ссылку на статью. - Говорите агенту: «ingest this» (обработай источник) — агент читает файл, запускает извлечение сущностей, создаёт или обновляет 5–15 страниц вики, добавляет кросс-ссылки.
- Проверяете результат — заглядываете в
wiki/через Obsidian, смотрите граф связей, проверяете цитаты. - Повторяете — каждый новый источник компилируется в вики и обогащает уже существующие страницы.
Важно: не пытайтесь залить всё сразу. Начните с 5–10 ключевых источников по проекту. Вики должна расти, а не быть свалкой.
Как обновлять
Обновление — это не ручное редактирование всех страниц. Это перекомпиляция затронутых участков:
- Новый источник на ту же тему → агент обновляет существующие страницы сущностей/концепций, добавляет новые связи.
- Противоречие с существующей страницей → агент помечает страницу флагом
contradictionи добавляет ссылку на источник противоречия. - Lint-команда → регулярный прогон
/wiki lintпроверяет битые ссылки, устаревшие страницы, отсутствующие свойства, утечки credentials.
Как автоматизировать
Автоматизация строится вокруг трёх уровней:
| Уровень | Что автоматизируется | Инструменты |
|---|---|---|
| Ingest | Обработка нового файла в raw/ | Watch-mode на файловой системе, MCP-сервер, CLI |
| Maintenance | Lint, ребилд индекса, коммиты в git | /wiki lint, cron/launchd/systemd, scheduled-sync |
| Query | Ответы на вопросы из вики с цитатами | MCP-инструменты, skills, ACP-протокол |
Каждая операция завершается автоматическим git-коммитом — полная история изменений вики у вас под рукой.
Интеграция со скилами, MCP и тасками
LLM-wiki не существует в вакууме. Он встраивается в современный агентный стек через три ключевых протокола:
MCP (Model Context Protocol)
MCP-сервер — это «мост» между вики и агентом. Он выставляет типизированные инструменты, которые агент может вызывать: чтение страниц, поиск, ingest, линтинг, работа с графом. Вот пример набора инструментов:
| Группа | Инструменты |
|---|---|
| Пространства | wiki_spaces_create, wiki_spaces_list, wiki_spaces_remove |
| Контент | wiki_content_read, wiki_content_write, wiki_content_new |
| Поиск | wiki_search, wiki_list, wiki_index_rebuild |
| Граф | wiki_graph |
| Аудит | wiki_lint, wiki_stats |
MCP-серверы для LLM-wiki уже доступны на npm, PyPI и в виде нативных бинарников.
Скилы
Скилы — это оркестраторы, которые учат агента как использовать MCP-инструменты в правильной последовательности. Типовой набор скилов для LLM-wiki:
- setup — однократная настройка Vault’а и регистрация MCP-сервера.
- ingest — обработка источника: извлечение сущностей, создание страниц, кросс-ссылки.
- crystallize — дистилляция текущей сессии в durable-страницы вики.
- research — поиск по вики и синтез ответа с цитатами.
- lint — аудит качества: сироты, битые ссылки, целостность схемы.
- graph — генерация и интерпретация графа концепций.
Скилы работают поверх MCP-инструментов: MCP даёт примитивы, скилы собирают из них рабочие процессы.
Таски и автоматизация
LLM-wiki естественно встраивается в таск-менеджмент:
- Ingest-таск — фоновое задание на обработку нового источника. Запускается по появлению файла в
raw/. - Lint-таск — ежедневная (или еженедельная) проверка здоровья вики.
- Research-таск — по запросу пользователя: «найди в вики всё про X и сделай саммари».
- Evolution-таск — продвинутый сценарий: агент учится на завершённых задачах, консолидирует паттерны и предлагает улучшения скилов.
Экономия токенов: цифры и нюансы
Самый частый вопрос: «Сколько это экономит?» Вот данные из независимых бенчмарков:
| Метрика | Vanilla (прямое чтение) | LLM-wiki | Graphify (GraphRAG) |
|---|---|---|---|
| Токены (среднее) | 755K | 350K (−54%) | 617K |
| Время (среднее) | 167s | 101s (−39%) | 180s |
| Качество (из 25) | 15.1 | 16.0 | 13.6 |
Откуда берётся экономия
Секрет — в асимметричном распределении стоимости:
- RAG: каждый запрос = эмбеддинг + векторный поиск + инжекция чанков + повторный синтез с нуля.
- LLM-wiki: один раз при ingest = компиляция, суммаризация, кросс-ссылки. При каждом запросе = чтение уже готовой markdown-страницы.
«Скомпилируй один раз — запрашивай сколько угодно» — вот формула экономии.
Когда экономии нет
Если задача — найти конкретную строку в одном файле или сделать простой grep, прямое чтение будет быстрее и точнее, чем поход в вики. LLM-wiki выигрывает на задачах, требующих синтеза из нескольких источников.
Выводы
- LLM-wiki — это паттерн, а не продукт. Его можно реализовать на любом агентном фреймворке: Claude Code, Codex, Cursor, Hermes. Главное — дисциплина структуры и регулярный lint.
- Это не замена RAG, а дополнение. Для небольших (<100K токенов) стабильных баз знаний LLM-wiki даёт высокую точность и связность. Для больших динамичных корпусов RAG остаётся практичным выбором.
- Экономия токенов реальна, но не универсальна. На задачах синтеза — до 54% меньше токенов. На задачах «найди строку» — прямое чтение эффективнее.
- Автоматизация — ключ к устойчивости. Без lint, git-коммитов и scheduled-тасков вики деградирует. С ними — это живой, компаундящийся актив.
- Интеграция с MCP и скилами делает LLM-wiki «родным» для агентов. MCP даёт примитивы, skills — рабочие процессы, таски — автоматизацию. Вместе это полноценный «второй мозг».
Заключение
Если вы уже ведёте второй мозг для себя в Obsidian — вы понимаете ценность внешней структурированной памяти. LLM-wiki — это тот же принцип, но для вашего ИИ. Вместо того чтобы каждый раз пересказывать агенту контекст проекта и надеяться, что он не забудет, вы строите вики, которая растёт вместе с проектом.
Второй мозг нужен не только вам. Он нужен вашему ИИ.
Начните с малого: создайте хранилище, положите туда 5 ключевых документов, дайте агенту команду ingest. Через неделю у вас будет база, к которой агент будет обращаться сам — и вы заметите, что стали меньше объяснять и больше делать.